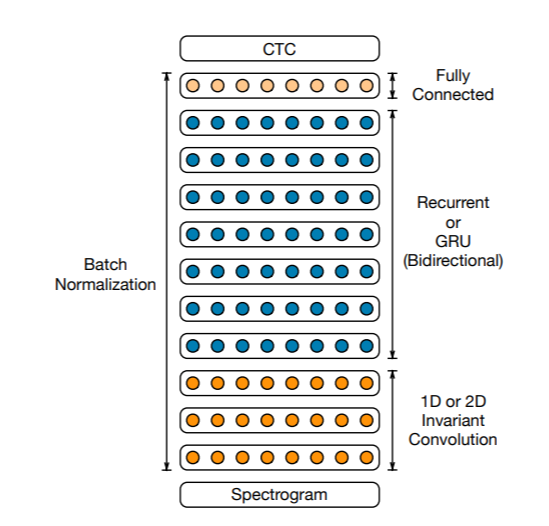
한국어는 초성/중성/종성이라는 세 가지 자소 (grapheme)를 하나로 결합한 형식으로 하나의 음절을 구성한다. 각각 초성 19개, 중성 21개, 종성 28개로 이루어져 있어, 한국어 음절 단위로 모델의 출력을 구성할 경우 총 11,172개의 출력을 필요로 한다. 따라서 영어를 기반으로 구성된 end-to-end 음성인식을 한국어에 그대로 적용할 수 없다.
따라서 두 가지 방법을 고려할 수 있다.
중국어의 경우, 가능한 음절의 개수가 일상적으로 쓰는 음절만 추려도 약 8,000개 정도이다. 대표적인 중국어 음성인식 모델로는 Baidu의 Deepspeech2가 있는데, 해당 연구에서는 가장 많이 사용하는 6,000개의 문자를 출력한다. 표음문자인 한국어는 중국어와 비교해서 한 문장의 평균 음절의 개수가 많아 효율적인 훈련이라 볼 수 없다.
첫 번째 네트워크는 feature-to-grapheme 네트워크로 구성하고, 두 번째 네트워크는 grapheme-to-text 네트워크를 구성하여 각각 학습하는 방법이다. 자소 기반으로 네트워크를 구성할 경우, 추정해야 하는 parameter의 수가 음절 기반의 11,172개에서 49 개로 줄어들기 때문에 효율적인 학습이 가능하다.
음성 인식에 있어서 end-to-end system을 구현하는 방법은 지금까지 3가지가 제안되었다.
CTC는 deep learning 모델의 output layer에서 output node의 objective function의 일종으로, signal feature에서 직접 phoneme sequence를 추출하기 때문에 forced alignment 정보가 필요없다. frame 단위의 출력만을 처리하여 모델의 형태가 단순하고, 적은 training data를 필요로 함
attention network는 sequence-to-sequence 모델로, 입력과 출력이 data series로 주어지는 방법을 말한다. encoder model의 결과에서 중요하다고 생각되는 output node의 값을 강조한다. sequence들을 하나의 네트워크에 한 번에 입력해야 해서 online decoding에 활용할 수 없다.